






RAGFlow 是一款领先的开源检索增强生成(RAG)引擎,通过融合前沿的 RAG 技术与 Agent 能力,为大型语言模型提供卓越的上下文层。它提供可适配任意规模企业的端到端 RAG 工作流,凭借融合式上下文引擎与预置的 Agent 模板,助力开发者以极致效率与精度将复杂数据转化为高可信、生产级的人工智能系统。
请登录网址 https://cloud.ragflow.io 体验云服务。
如果想在本地部署,请参阅本地部署。


- 2026-09-10 支持通过 Sitemap 接入网站内容。
- 2026-08-19 推出知识编译,支持在文档级和知识库级生成 Wiki、Graph、Tree、PageIndex、Mind Map、Timeline 及 Skills。
- 2026-08-19 推出 Agentic RAG,支持 Low、Medium、High、Ultra 四种思考模式。
- 2026-07-02 支持 Google BigQuery 数据源接入与增量同步。
- 2026-06-29 支持 WhatsApp、钉钉和企业微信聊天渠道。
- 2026-05-26 新增 Browser 组件,支持 Agent 自主浏览和操作网页。
- 2026-04-21 提供七种预置数据摄取流水线模板。
- 2026-04-21 支持 Agent 应用发布、沙箱代码执行与图表生成。
- 2026-04-21 支持用户级记忆存储和检索。
更多更新请参阅完整发布记录。
⭐️ 点击右上角的 Star 关注 RAGFlow,可以获取最新发布的实时通知!🌟

- 基于深度文档理解,能够从各类复杂格式的非结构化数据中提取真知灼见。
- 真正在无限上下文(token)的场景下快速完成大海捞针测试。
- 不仅仅是智能,更重要的是可控可解释。
- 多种文本模板可供选择。
- 支持文档级和知识库级编译,将原始内容组织为结构化的知识产物。
- 通过编译模板生成 Wiki、Graph、Tree、PageIndex、Mind Map、Timeline 及 Skills,满足不同的知识组织和复用需求。
- 支持配置编译模型与处理规则,并查看、更新和重新生成知识产物。
- 面向复杂问题进行多步检索:模型会分析问题,并在需要时执行问题拆解、知识检索和证据核验。
- 通过多轮检索与推理获取更完整的上下文,帮助生成有依据的回答。
- 支持 Low、Medium、High、Ultra 思考模式,可按问题复杂度控制检索和推理深度。
- API、Admin、Ingestor 和 Syncer 由 Go 服务统一提供。
- DeepDoc 在 Go 进程内运行,负责版面分析、OCR 和表格识别。
- Go 服务通过 CGO 调用原生文档解析库和 ONNX Runtime。
- MCP 和 Sandbox Executor 作为可选能力按需启用。
- 文本切片过程可视化,支持手动调整。
- 有理有据:答案提供关键引用的快照并支持追根溯源。
- 支持丰富的文件类型,包括 Word 文档、PPT、Excel 表格、TXT 文件、图片、PDF、影印件、复印件、结构化数据、网页等。
- 自动化的 RAG 工作流可以支持从个人应用乃至超大型企业的各类生态系统。
- 大语言模型 LLM 以及向量模型均支持配置。
- 基于多路召回、融合重排序。
- 提供易用的 API,可以轻松集成到各类企业系统。
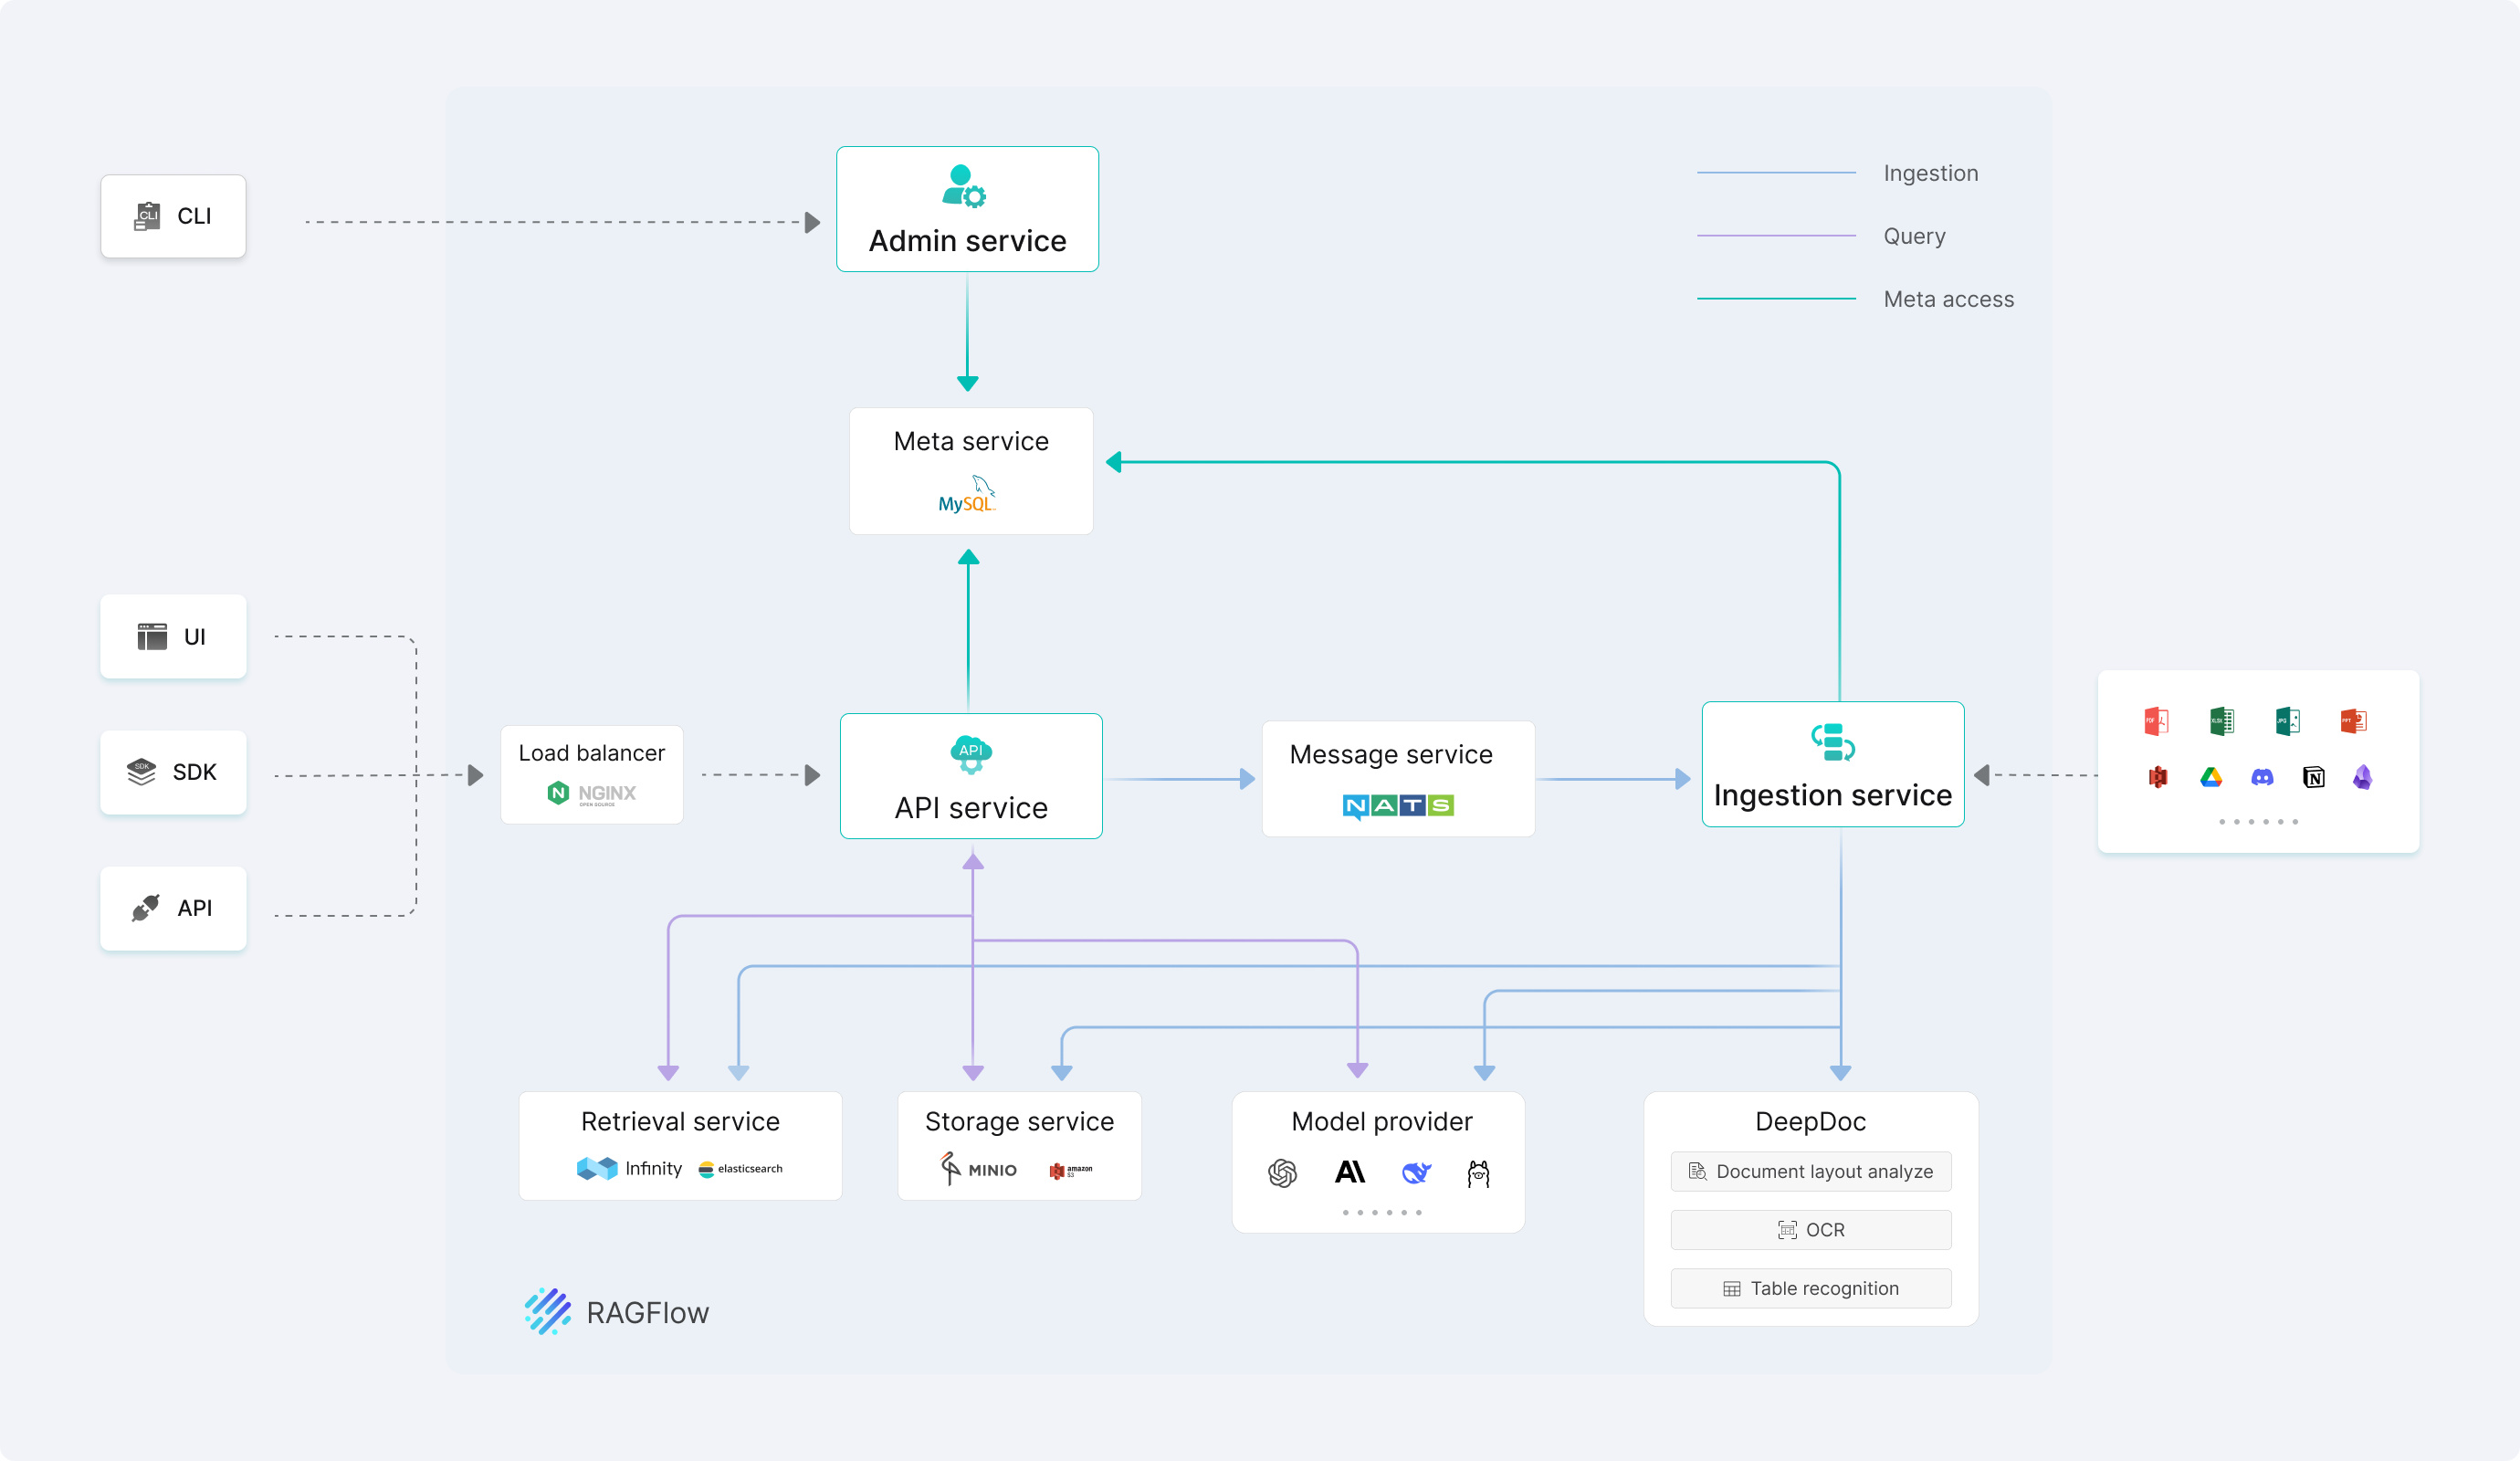
本地部署提供 Docker 部署和源码启动两种方式:Docker 适合快速体验、集成测试和生产部署;源码启动适合 Go 服务开发、调试和二次开发。Docker 部署无需安装 Go,源码启动需要安装 go.mod 指定的 Go 版本;前端开发还需要 Node.js 和 npm。
- 建议起步配置:4 核 CPU、16 GB 内存和 50 GB 可用磁盘。实际资源需求取决于文档引擎、数据规模、解析任务和并发量;启用本地模型或其他额外组件时,请同时满足相应组件的资源要求。
- Docker ≥ 24.0.0,Docker Compose ≥ v2.26.1。
- gVisor:仅在使用 Self-Managed 容器 Sandbox 时需要安装和配置。
Docker 部署无需在宿主机安装 Go。使用 Self-Managed 容器 Sandbox 时需要额外安装和配置 gVisor,其他 Sandbox Provider 不要求在 RAGFlow 主机上安装 gVisor。
⚠️ 提示: 如果你尚未在本机安装 Docker(Windows、macOS 或 Linux),可以参考 Install Docker Engine 自行安装。
-
如果使用 Elasticsearch,将 Docker 主机的
vm.max_map_count设置为至少 262144。使用 Infinity 时通常不需要执行此步骤:如需确认
vm.max_map_count的大小:sysctl vm.max_map_count
如果使用 Elasticsearch 且
vm.max_map_count的值小于 262144,可以进行重置:# 这里我们设为 262144: sudo sysctl -w vm.max_map_count=262144你的改动会在下次系统重启时被重置。如果希望做永久改动,还需要在 /etc/sysctl.conf 文件里把
vm.max_map_count的值再相应更新一遍:vm.max_map_count=262144
-
克隆仓库:
git clone https://github.com/infiniflow/ragflow.git
-
切换到 Go 版发布标签并使用 Docker Compose 启动服务器:
⚠️ 提示:v1.0.0-rc1及之后的发布标签使用 Go 实现。详细平台和 macOS 要求请参阅Go Docker 镜像构建与平台支持说明。进入仓库中的 Docker 部署目录。
cd ragflow/docker切换到 Go 版
v1.0.0-rc1发布标签。git checkout v1.0.0-rc1
在后台启动 Go 服务及其依赖服务。
docker compose -f docker-compose.yml up -d
💡 镜像下载提示: 如果无法从默认仓库拉取 Go 镜像,请先在
docker/.env中将RAGFLOW_IMAGE设置为以下镜像源之一,并保留v1.0.0-rc1标签:- 华为云:
swr.cn-north-4.myhuaweicloud.com/infiniflow/ragflow:v1.0.0-rc1 - 阿里云:
registry.cn-hangzhou.aliyuncs.com/infiniflow/ragflow:v1.0.0-rc1
默认 MySQL 配置下,Go 镜像入口会先执行数据库迁移,再通过
bin/ragflow_server启动 Syncer、Admin、API 和 Ingestor。RAGFlow 开源版 1.0 的 DeepDoc 版面分析、OCR 和表格识别使用 CPU 推理。
- 华为云:
-
服务器启动成功后再次确认服务器状态:
使用
docker ps检查依赖服务状态;依赖服务显示healthy且 RAGFlow 容器持续运行后,通过 HTTP 接口判断 RAGFlow 是否就绪(RAGFlow 容器本身未定义 Compose healthcheck):curl -f http://localhost/api/v1/system/healthz
返回 HTTP 200 后,再访问 Web 页面。如果修改了
SVR_WEB_HTTP_PORT,请将健康检查地址中的端口替换为对应值。如果服务启动异常,再查看对应容器日志:
docker logs --tail 50 ragflow-cpu
-
在你的浏览器中输入你的服务器对应的 IP 地址并登录 RAGFlow。
上面这个例子中,您只需输入 http://IP_OF_YOUR_MACHINE 即可:未改动过配置则无需输入端口(默认的 HTTP 服务端口 80)。
-
登录 RAGFlow 后,在模型提供商页面添加 LLM、Embedding 和 Reranker,并填写对应的模型名称、服务地址和 API key。
好戏开始,接着奏乐接着舞!
详情请见 快速入门指南。
Go 版 Docker 部署使用 docker/.env 和 docker/docker-compose.yml,使用 Kvrocks 存储缓存和 Checkpoint,并使用 NATS JetStream 作为消息队列。镜像、端口、密码、文档引擎及模型镜像源请按Docker 配置说明修改;平台限制和 macOS 运行要求请参阅Go Docker 镜像构建与平台支持指南。源码构建 Docker 镜像请参阅Go Docker 镜像构建与平台支持指南。
切换文档引擎、修改配置后重启服务,以及保留或清理已有数据的操作,也请按照上述 Docker 配置文档执行。
源码启动请安装 go.mod 中指定的 Go 版本(当前为 Go 1.27)、Clang 20、LLD 20、CMake ≥ 4.0、PCRE2 开发文件和 CGO 所需的原生库。仅开发 React 前端时需要 Node.js 和 npm。
-
克隆仓库,并安装
go.mod中指定的 Go 版本(当前为 Go 1.27)、Clang 20、LLD 20、CMake ≥ 4.0,以及 PCRE2 开发文件。Go 服务依赖 CGO 和原生静态库;build.sh 会设置所需的构建参数。git clone https://github.com/infiniflow/ragflow.git cd ragflow -
按 Go 依赖下载脚本准备原生库、模型文件和 tokenizer 资源,再编译 Go 服务:
python3 -m venv /tmp/ragflow-go-download-venv
/tmp/ragflow-go-download-venv/bin/python -m pip install requests huggingface-hub
/tmp/ragflow-go-download-venv/bin/python ragflow_deps/download_deps.py
bash build.sh --all
下载脚本负责准备 Go 构建所需的原生库和模型资源,并需要
requests和huggingface-hub。如果已通过其他方式准备好相同资源,可跳过这一步。Go 服务从仓库根目录启动时会自动查找internal/rag/res/deepdoc;如需从其他目录启动,请将DEEPDOC_MODEL_DIR设为该目录的绝对路径。 -
启动本地依赖服务,并确认 conf/service_conf.yaml 中的主机与端口对应宿主机可访问的地址。Go 源码服务通过
localhost:6379连接 Compose 暴露的 Kvrocks;Go Docker 服务则在容器网络中连接 Kvrocks。如果使用默认 Elasticsearch,还需先将 Docker 主机的vm.max_map_count设为至少262144。sudo sysctl -w vm.max_map_count=262144 docker compose --env-file docker/.env -f docker/docker-compose-base.yml \ up -d --wait es01 mysql minio nats kvrocks clickhouse
-
先迁移数据库,再分别在 5 个独立终端中按顺序启动 Go 服务(命令均在仓库根目录运行)。每次只在对应终端中执行该终端下方的命令,不要把所有命令一次性粘贴到同一个终端。迁移命令无需设置
RAGFLOW_DEV_MODE;开发环境中的 Admin、Ingestor、Syncer 和 API 按下方命令设置RAGFLOW_DEV_MODE=true。迁移命令执行完成后即可关闭终端,其他 4 个服务终端需要保持运行。终端 1:迁移数据库。
./bin/ragflow_server --migrate
终端 2:启动 Admin(目标端口
9381)。RAGFLOW_DEV_MODE=true ./bin/ragflow_server --admin
终端 3:启动 Ingestor。
RAGFLOW_DEV_MODE=true ./bin/ragflow_server --ingestor
终端 4:启动 Syncer。
RAGFLOW_DEV_MODE=true ./bin/ragflow_server --syncer
终端 5:启动 API(目标端口
9380)。RAGFLOW_DEV_MODE=true ./bin/ragflow_server --api
各启动模式的作用如下:
--migrate:执行数据库迁移,完成后即可退出。--admin:启动 Admin 服务,负责管理和初始化操作。--ingestor:启动 Ingestor 服务,负责数据摄取和解析任务。--syncer:启动 Syncer 服务,负责数据同步任务。--api:启动 API 服务,为 Web、SDK 和外部客户端提供接口。
RAGFLOW_DEV_MODE=true仅用于开发环境关闭代码版本与数据库迁移版本之间的降级检查,不会执行迁移或改变数据库结构,生产部署不要设置此变量。Admin 应先于其他服务启动。数据库迁移完成后,RAGFLOW_DEV_MODE=true bash build.sh --run可作为便捷方式启动 Admin、Ingestor 和 API;该命令不启动 Syncer,需要完整服务链路时仍应另行执行RAGFLOW_DEV_MODE=true ./bin/ragflow_server --syncer。 -
仅在前端开发时安装 Node.js 和 npm,然后启动 React 前端:
cd web
npm install
API_PROXY_SCHEME=go npm run dev
服务启动后,在另一个终端确认 Go API 已就绪:
curl -f http://127.0.0.1:9380/api/v1/system/healthz
返回 HTTP 200 表示 API 可以正常响应。前端、ClickHouse 和 DeepDoc 的完整验证步骤请参阅从源代码启动服务。
开发结束时,在各服务终端按
Ctrl+C停止进程。如需停止依赖但保留容器以便下次使用,运行docker compose --env-file docker/.env -f docker/docker-compose-base.yml stop es01 mysql minio nats kvrocks clickhouse;如需删除依赖容器和 Compose 网络但保留命名数据卷,运行docker compose --env-file docker/.env -f docker/docker-compose-base.yml down。
详情请见 从源代码启动服务。
详见 RAGFlow Roadmap 2026 。
RAGFlow 只有通过开源协作才能蓬勃发展。秉持这一精神,我们欢迎来自社区的各种贡献。如果您有意参与其中,请查阅我们的贡献者指南。
扫二维码添加 RAGFlow 小助手,进 RAGFlow 交流群。
